
暑期集训-分治

分治杂谈
前言:分治是基础算法(提高-)中最重要,也是最常用到的思想,能够理解分治、熟练应用分治,可以为后续的算法学习打下厚实的基础。
分治思想的算法非常多,今天将从简单到难进行粗略的讲解,对经典题目进行选讲。
分治( Divide ),意为 分而治之,将一个大问题划分两个(通常)小问题处理,再由小问题的解合并而来。
分治通常具有的复杂度,代表对数,通常指,也就是求2的x次方为n,。
简单来说:如果一个在问题中,每次会被÷2,那它一共会被除次。
100000
题外:今天的内容难度区分度较大,进度快的同学可以先自行写题。
快速排序
大家最早接触到的分治应该是快速排序。在初赛卷中,我们就做过不少类似快速排序思路的代码。
快速排序思路:
使用随机数选择一个点,通过左右指针的移动,让随机数左边的数字都比它小,右边的都比它大。
随后在左右再进行递归处理。

一般使用左右指针法实现
int partition(int arr[], int left, int right)  //找基准数 划分
{
   int i = left + 1 ;
   int j = right;
   int temp = arr[left];

   while(i <= j)
   {
       while (arr[i] < temp)
       {
           i++;
       }
       while (arr[j] > temp )
       {
           j--;
       }
       if (i < j)
           swap(arr[i++], arr[j--]);
       else i++;
   }
   swap(arr[j], arr[left]);
   return j;

}

void quick_sort(int arr[], int left, int right)
{
   if (left > right)
       return;
   int j = partition(arr, left, right);
   quick_sort(arr, left, j - 1);
   quick_sort(arr, j + 1, right);
}
由于选择的划分点是随机的,有可能随机到不好的情况,所以它的复杂度是不稳定的。
通过刚刚的代码我们可以看到,快速排序通过将大的序列划分为左右两个小的序列,不断的递归处理问题,解决了数组的排序。这个递归解决问题的过程其实就是分治。
题外:虽然快速排序可能劣化到O(n^2),但是通过三数取中法、插排堆排混合使用、优先递归小区间等方法优化后的std::sort()函数,基本上可以看成logn复杂度。在赛时请避免自己手写快排。
二分查找
我们学过O(n)复杂度的枚举查找方式,但是在数据有序的情况下,有一种更加高效的查找——二分查找。在长度为1000000的序列中,通过大概20次查找就能找到对应的数据。
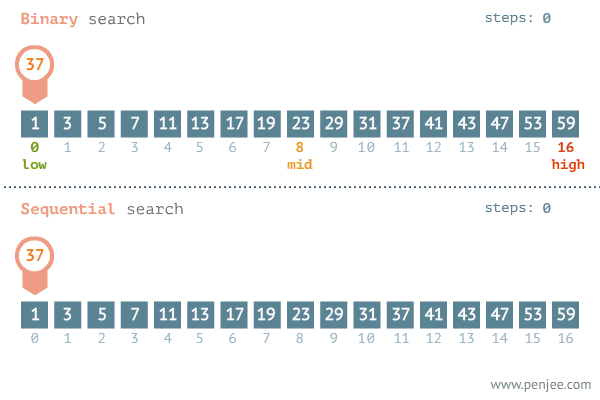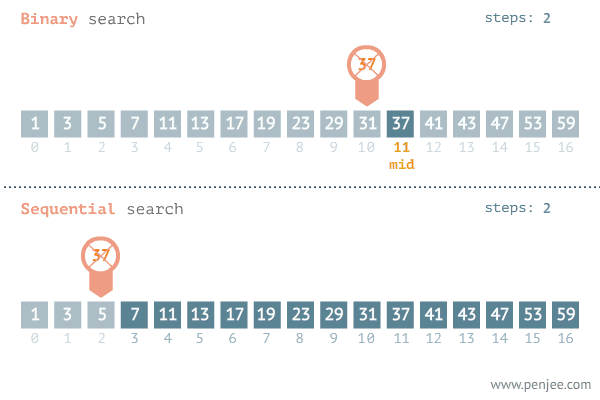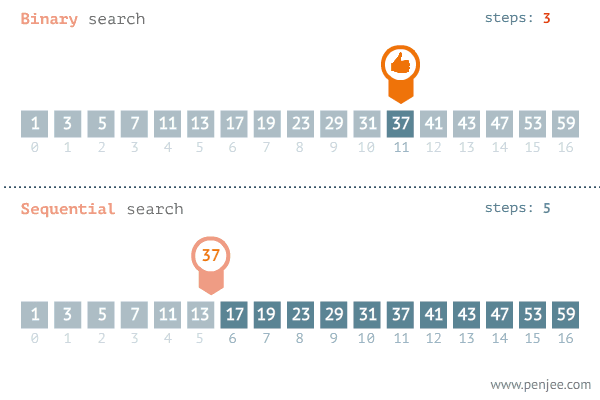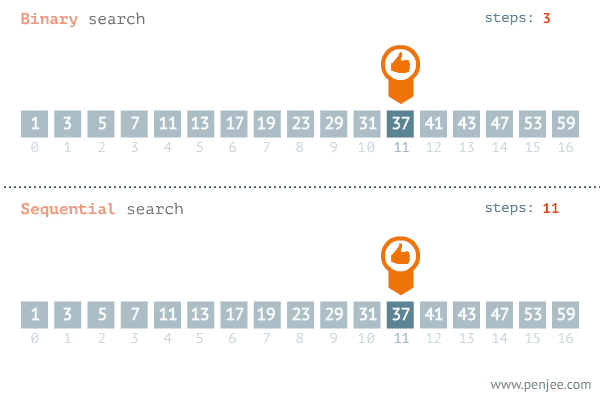
二分查找的代码实现比较简单,但是while循环内的内容比较绕。
int a[100];//假设a为升序数组
int l=1,r=n;//表示在数组[1,n]进行二分查找
int res= 10;//假设我们需要找10
while(l<=r){
    int mid=(l+r)/2;
    if(a[mid]<=res) l=mid+1;//如果当前的a小于要找的,说明要找的数在右边,我们将左端点右移。
    else r=mid-1;//反之,我们将左端点移动
}
cout<<r;
//cout<<l;
二分虽然快,但是有条件:数组需要排序,无论是升序还是降序。这种有序的数组才能满足可二分性。
例题:A 查找 (10分钟完成)
在竞赛中的应用——二分答案
对于二分的算法,经常出现的题目反而不是直接的查找。因为大部分的C++STL标准库容器都已经自带了二分查找的搜索,比如lower_bound(),find()等等。
例题:B 木材加工
我们需要找到木材能切成k段的最大值,首先要思考的:如去做一定是正确的。
朴素思路:枚举木材能切成某个长度x的,从1开始枚举,枚举到len最大。只要我们一个一个len去检查能不能切出k块木材就行了。
复杂度分析:木头长度可能有1e8,这样枚举显然会爆。
优化:我们发现木材切的长度越小,越能被切成k块;木材长度切的越长,越不能被切成k块。如果我们对每个长度的木材能否切成k块列一个数组表示木材每次都切成块时,0表示不能切出k块,1表示能切出,那么p[i]数组为1111111000000...以此类推。那么我们只需要找到最后一个1,此时p[i]=1,i就是能切出k块的最大长度。p[i]数组的长度为1e8,对它进行二分也仅有60的复杂度,但是我们无法处理出p[i]数组。那么能不能获取特定的p[i]的值呢?我们在二分的时候,只会询问p[mid],如果能快速求出p[mid],这个算法仍然可行。
假定:每次切的木材长度为mid,我们只需要for一遍所有木材,统计他们各自能切出多少块,最后查看他们有没有k个即可。
求出p[mid]的复杂度是O(n)的。算法总体复杂度为O(nlogL),能通过。
由于以上的二分是对答案直接进行二分,并在二分的过程当中求答案,又称为二分答案。
bool check(int mid){//检查mid是否符合要求


}
int main(){
    long long l=1,r=1e8;
    while(l<=r){
        long long mid = (l+r)/2;
        if(check(mid))l=mid+1;
        else r=mid-1;
    }
    cout<<r;
}
逆序对
逆序对,指一个所有元素各不相同的有序数组中满足i < j且A[i] > A[j]的有序对(A[i], A[j])。例如数组(3,1,4,5,2)包含4个逆序对:(3,1)、(3,2)、(4,2)、(5,2)。
对于逆序对问题,有个经典的归并排序算法可以求。
归并排序
归并排序的流程:
1.把数组划分为个数尽量相等的序列
2.往下递归1操作直到大小为1
3.把两个有序的序列合并成1个新的有序序列,一直往上合并。

- 图源博客园
归并排序的复杂度为nlogn且稳定。
实现代码
void msort(int l, int r)
{
    if(l >= r) return;
    int mid = (l + r) >> 1;
    msort(l, mid);//向下递归
    msort(mid + 1, r);
    int k = 0;
    int i = l, j = mid + 1;//刚刚处理完了左边[l,mid]与右边[mid+1,r]区间
    //下面为合并两个区间,借用数组b表示合并结果。 i:左区间 j右区间
    while(i <= mid && j <= r)
    {
        if(a[i] <= a[j]) b[++ k] = a[i ++];//如果左边小,就把下一位放左边
        else b[++ k] = a[j++];
    }
    while(i <= mid) b[++ k] = a[i ++];//把剩余的部分加进去
    while(j <= r) b[++ k] = a[j ++];
    for(int i = l; i <= r; i ++ ) a[i] = b[i - l + 1];//最后转移到原数组,完成合并
}
我们发现,在合并的过程中,数组自然被分成了两部分[l,mid]和[mid+1,r],如果左边的比右边的大,那不就是逆序对么。
假设a[i]>a[j],由于a[j]所属的右边的部分也是有序的,说明左边的a[i]~a[mid]都比a[j]要大,因此一次性产生了(mid-i+1)个逆序对。
  while(i <= mid && j <= r)
    {
        if(a[i] <= a[j]) b[++ k] = a[i ++];//如果左边小,就把下一位放左边
        else b[++ k] = a[j ++];
    }

//修改增加逆序对

  while(i <= mid && j <= r)
    {
        if(a[i] <= a[j]) b[++ k] = a[i ++];//如果左边小,就把下一位放左边
        else {
            b[++ k] = a[j ++];
            ans+=mid-i+1;

        }
    }
注意:逆序对个数非常多,是longlong类型。
根号分治
上述讲的分治问题都是log级别的,但是还有一种比较特殊的分治方法——根号分治。
根号分治是一种在对数据规模分类讨论的基础上利用不同算法平衡复杂度的思想。
例题:D Remainder Problem
对于这题,假设x特别大,大到100000之类的,我们可以想出一种做法:
mod x =y的数字会非常少,假设 x =100000,y=5,那么满足 k mod x = y 的k
只有 5 100005,200005.... 然而n只有500000。因此发现:如果暴力去找所有的下标modx=y的个数,为n/x个。那操作12的复杂度均为n/x;
但是x有可能非常小。如果x非常小的时候,我们不妨想一种策略:直接将所有的x与y存下来,这样消耗的空间复杂度只有x*x,我们定义表示下标mod x 为y的位置 被加的次数,如果询问2的x非常小,直接输出即可。
平衡这两种操作的复杂度,发现x为sqrt(x)的时候比较优秀(并不是最好),因此一般这种问题我们称为根号分治。
int a[800][800];
int b[MAXN];
void solve() {
	int n;
	cin>>n;
	int op,x,y;
	int N = sqrt(500000);
	for(int i=1; i<=n; i++) {
		cin>>op>>x>>y;
		if(op==1) {
			for(int i=1; i<=N; i++) {//处理所有小的情况
				a[i][x%i]+=y;
			}
			b[x]+=y;
		} else {
			if(x<=N) {
				cout<<a[x][y]<<"\n";
			} else {
				int ans=0;
				for(int i=y; i<=MAXN-5; i+=x) {
					ans+=b[i];
				}
				cout<<ans<<"\n";
			}
		}
	}

}
折半搜索
折半搜索 tag:meet in the middle
当搜索的复杂度过高时,我们不妨只搜一半,然后手动去合并。
假设我们搜索40个物品是否存在(0/1)需要次,但是搜索20个物品只需要次,而暴力枚举每个物品的情况,对结果合并,也只是复杂度。
例题E :世界冰球锦标赛
vector<int> va,vb;
int l,r;
void dfs1(int id,int sum){
	if(id>l){
		if(id==l+1)
		va.push_back(sum);
		return;
	}
	dfs1(id+1,sum+a[id]);
	dfs1(id+1,sum);
}
void dfs2(int id,int sum){
	if(id<r){
		if(id==r-1)
		vb.push_back(sum);
		return;
	}
	dfs2(id-1,sum+a[id]);
	dfs2(id-1,sum);
}
int main(){
    l=(n+1)/2,r=l+1;//划分两半
    dfs1(1,0);
	dfs2(n,0);
    sort(va.begin(),va.end());
    for(auto &it:vb){
        ans+=upper_bound(va.begin().va.end(),M-it)-va.begin();
        //这个代码是 找有多少个前半搜索结果是加起来小于等于M的
        //upper_bound是找大于M-it的第一个数,意思是我们距离正确答案往右边走了一位
        //但是-ka.begin又少了一位,所以刚刚好
    }
}
我们对搜索的情况也进行分治的时候,发现复杂度发生了显著的变化。但这只对我们可以有效合并的内容起作用。如果你拆分了两个搜索,但是无法合并,也没有用。
题外:看到n=30~50,要思考折半搜索是否是一种正解。
整体二分
题外:如果你没有学过高级数据结构,请不要尝试H题,对前置知识有较高要求。
整体二分是一种特殊的离线算法,如果说根号分治是对答案进行二分,那么整体二分就是对询问进行二分。
从静态区间第k小题目(H 可持久化线段树 2)来看,每次询问的区间为[l,r],我们将所有的[l,r]离线下来。设n为值域(也就是答案)最大值。递归从(1,n)开始,我们遍历原数组的每一个数字,如果它比mid要大,就给数据结构(后记为 树状数组) 上的pos(数组的第几位)+1。
随后遍历我们所有的询问,如果他们的询问区间[l,r]内,1的个数(也就是超过mid的东西)个数x要比k大,则要往大了找,于是我们把这个问题塞入vector,递归到(mid+1,n)区间处理。
*注意:往右边找的时候,为了保证整体二分的复杂度,首先要对问题进行划分,如果值域为(1,mid),我们就不需要考虑数组上大于mid 的数字了,所以左边只用考小于mid 的数字,同理,右边也是。但是右边的询问计算的时候,小于mid 的数字被少加了!(本来应该都加的),所以我们的处理方式是递归到右边问题时把询问的k直接减少x个。
整体二分的函数如下参考:(并不是H题的
由于有数据结构在,加上每个数会被加logn次,复杂度为nlognlogn
void calc(int l,int r,int ql,int qr) {
	if(ql>qr) return;
	int mid=l+r>>1;

	if(l==r) {
        //值域递归到头了,把所有询问赋上答案
		for(int i=ql; i<=qr; i++) ans[q[p[i]].id]=l;
		return;
	}
	int cnt1=0,cnt2=0;
	for(int i=l; i<=mid; i++) {//处理l~mid  的数据
		add(e[i].l,e[i].r,e[i].w);
	}
	for(int i=ql; i<=qr; i++) { //处理该区间的询问
		int tmp=0;
		for(auto &it:q[p[i]].pos) {
			tmp+=getsum(it);
		}
		if(tmp>=q[p[i]].a) p1[++cnt1]=p[i];
		else q[p[i]].a-=tmp,p2[++cnt2]=p[i];//*如果向右要直接减去原来的量
	}
	for(int i=ql; i<=ql+cnt1-1; i++) {//处理新的左区间询问
		p[i]=p1[i-ql+1];
	}
	for(int i=ql+cnt1; i<=qr; i++) {//处理新的右区间询问
		p[i]=p2[i-ql-cnt1+1];
	}
	for(int i=l; i<=mid; i++) {//清空处理,防止影响后面
		add(e[i].l,e[i].r,-e[i].w);
	}
	calc(l,mid,ql,ql+cnt1-1);
	calc(mid+1,r,ql+cnt1,qr);

}
- 状态
- 已结束
- 规则
- IOI
- 题目
- 9
- 开始于
- 2026-7-10 8:00
- 结束于
- 2026-7-10 18:00
- 持续时间
- 10 小时
- 主持人
-
youxr
- 参赛人数
- 64